Almacenamiento ZFS para virtualización: guía práctica para Proxmox
¿Espejos o RAIDZ? ¿Sirve un SLOG? ¿Cuánta RAM darle al ARC? Guía práctica de ZFS en servidores Proxmox, con comandos, tablas de decisión y los errores que conviene evitar.
ZFS es la opción de almacenamiento local más completa para un servidor de virtualización Proxmox: combina gestión de volúmenes, checksums, compresión, snapshots y replicación en un solo sistema. Para cargas de VMs, la mejor configuración por defecto son espejos en franja (striped mirrors) sobre SSD empresariales con ashift=12 y compresión lz4, un ARC dimensionado a conciencia y respaldos reales en otro equipo. En esta guía explicamos las decisiones que importan, con comandos que puede adaptar y los errores que vemos con más frecuencia.
Puntos clave
- Use espejos para discos de VMs y bases de datos; use RAIDZ2 para destinos de respaldo y almacenamiento masivo. El I/O aleatorio escala con la cantidad de vdevs, no con la cantidad de discos.
- Defina
ashift=12al crear el pool (no se puede cambiar después) y active la compresiónlz4. - El ARC es la RAM que ZFS usa como caché de lectura; póngale un límite para que las VMs tengan memoria suficiente.
- Un SLOG solo acelera escrituras síncronas. Un vdev especial guarda metadatos y debe ir en espejo, porque si se pierde se pierde el pool.
- Los snapshots no son respaldos. Combine ZFS con Proxmox Backup Server y una copia fuera de la oficina.
Por qué ZFS en servidores de virtualización
ZFS calcula un checksum de cada bloque y lo verifica al leerlo, así detecta la corrupción silenciosa y, con redundancia, la repara automáticamente. Además ofrece snapshots instantáneos, replicación eficiente entre nodos y compresión transparente, todo integrado en el instalador y la interfaz web de Proxmox VE. La contrapartida es que ZFS premia el buen diseño inicial: algunas decisiones (la estructura de vdevs, el ashift) son difíciles o imposibles de cambiar cuando el pool ya tiene datos.
Espejos vs RAIDZ para máquinas virtuales
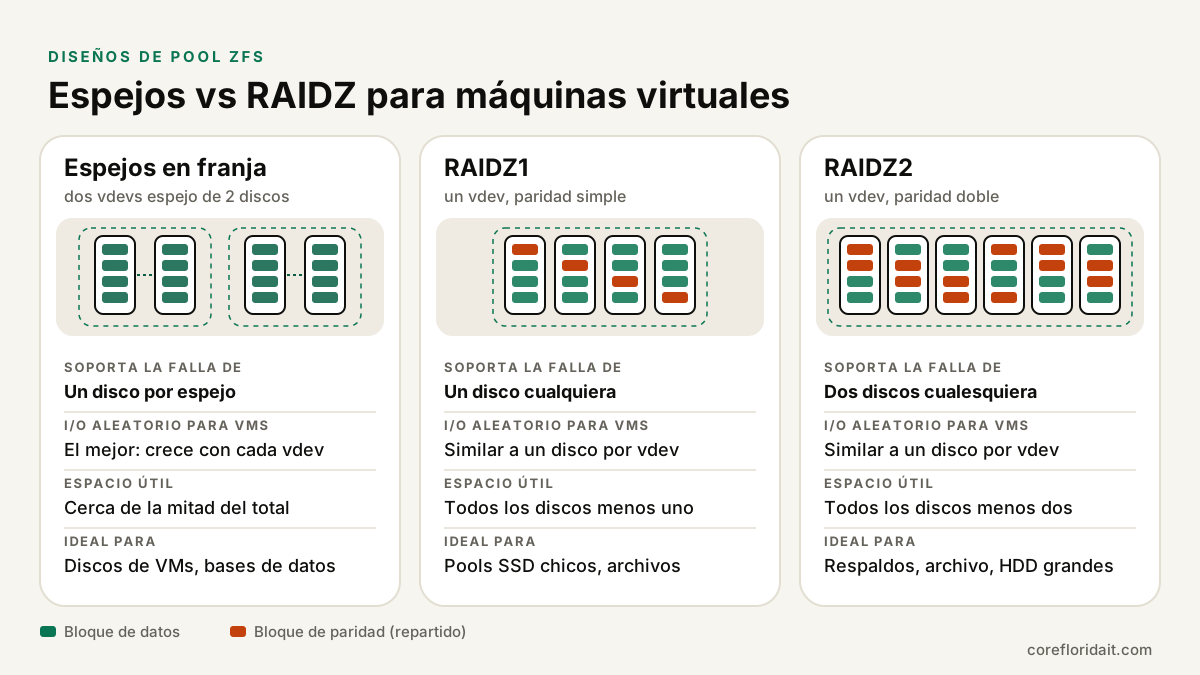
Un pool se compone de uno o más vdevs y ZFS reparte los datos entre ellos. La redundancia está dentro de cada vdev. El dato clave de rendimiento, que la documentación de Proxmox también destaca, es que un vdev RAIDZ ofrece IOPS aleatorias similares a las de un solo disco, mientras que cada vdev espejo adicional suma más.
| Diseño | Soporta la falla de | I/O aleatorio para VMs | Espacio útil | Ideal para |
|---|---|---|---|---|
| Espejos en franja (2 discos) | Un disco por vdev espejo | El mejor; crece con cada vdev | Cerca de la mitad del total | Discos de VMs, bases de datos, cargas mixtas |
| RAIDZ1 | Un disco cualquiera por vdev | Similar a un disco por vdev | Todos los discos menos uno | Pools SSD chicos; evitar con HDD grandes |
| RAIDZ2 | Dos discos cualesquiera por vdev | Similar a un disco por vdev | Todos los discos menos dos | Respaldos, carpetas compartidas, archivo |
| RAIDZ3 | Tres discos por vdev | Similar a un disco por vdev | Todos los discos menos tres | Vdevs HDD muy anchos para datos fríos |
Otras consideraciones:
- Tiempo de reconstrucción (resilver). Un espejo se reconstruye copiando un disco; RAIDZ debe leer todo el vdev. Con discos duros grandes, un resilver largo aumenta la exposición a una segunda falla; por eso no se recomienda RAIDZ1 con HDD de gran capacidad.
- Sobrecarga de espacio de zvols en RAIDZ. Los discos de VMs son zvols con bloques chicos. En RAIDZ, la paridad y el relleno de bloques pequeños pueden ocupar mucho más espacio del esperado. Los espejos no tienen ese problema.
- Crecimiento. Un pool de espejos crece agregando otro par. Las versiones recientes de OpenZFS permiten expandir un vdev RAIDZ agregando un disco, pero conviene planificar la capacidad en lugar de depender de eso.
Un diseño típico para una oficina pequeña en Doral o Coral Gables: cuatro o seis SSD empresariales en espejos en franja para las VMs, y un RAIDZ2 de discos duros aparte (o un servidor de respaldo dedicado) para los respaldos.
Crear el pool: ashift y compresión
ashift define el tamaño mínimo de sector del pool como potencia de dos. Los discos modernos usan sectores físicos de 4K aunque reporten 512 bytes, así que use ashift=12. Un valor demasiado chico perjudica mucho el rendimiento y no se puede cambiar una vez creado el vdev.
## Identificar discos por IDs estables, nunca por /dev/sdX
ls -l /dev/disk/by-id/ | grep -v part

## Dos vdevs espejo (espejos en franja) para las VMs
zpool create -o ashift=12 vmpool \
  mirror /dev/disk/by-id/nvme-DISCO_A /dev/disk/by-id/nvme-DISCO_B \
  mirror /dev/disk/by-id/nvme-DISCO_C /dev/disk/by-id/nvme-DISCO_D

## Compresión para todo lo que cuelgue del pool
zfs set compression=lz4 vmpool
zfs get compression,compressratio vmpool

## Agregarlo a Proxmox como almacenamiento de VMs y contenedores
pvesm add zfspool vmpool --pool vmpool --content images,rootdir
Compresión. lz4 es muy rápida y abandona enseguida los datos que no se comprimen, por lo que es una opción segura para VMs; muchas veces mejora el rendimiento porque llegan menos datos a los discos. zstd comprime más a cambio de más CPU y encaja bien en datasets de respaldo o archivo (zfs set compression=zstd backup/archivo).
zvols vs datasets
En almacenamiento ZFS, Proxmox guarda los discos de VMs como zvols (dispositivos de bloques) y los discos raíz de contenedores como datasets (sistemas de archivos).
| zvol | dataset | |
|---|---|---|
| Qué es | Dispositivo de bloques virtual | Sistema de archivos POSIX |
| Se usa para | Discos de VMs | Contenedores LXC, carpetas compartidas, ISOs y respaldos |
| Ajuste clave | volblocksize (se fija al crearlo) |
recordsize (modificable; aplica a escrituras nuevas) |
Las versiones recientes de OpenZFS y Proxmox usan por defecto un volblocksize de 16K para zvols, un punto medio razonable. La opción blocksize del almacenamiento en Proxmox lo controla para discos nuevos. No lo cambie sin probar con su carga real.
ARC: cuánta RAM debería usar ZFS
El ARC (Adaptive Replacement Cache) mantiene en RAM los datos usados con frecuencia y recientemente. Es la razón principal por la que las lecturas en ZFS son rápidas, pero en un hipervisor compite con las VMs por la memoria. Desde Proxmox VE 8.1, las instalaciones nuevas limitan el ARC por defecto a una fracción de la RAM; en sistemas más antiguos puede crecer mucho más. La documentación de Proxmox sugiere como punto de partida una base pequeña más alrededor de 1 GiB por cada TiB de almacenamiento, y luego ajustar según la tasa de aciertos observada.
## Ver tamaño actual del ARC y estadísticas de aciertos
arc_summary | head -40

## Limitar el ARC a 16 GiB (valor en bytes), persistente tras reiniciar
echo "options zfs zfs_arc_max=17179869184" > /etc/modprobe.d/zfs.conf
update-initramfs -u -k all
## Aplicarlo de inmediato sin reiniciar
echo 17179869184 > /sys/module/zfs/parameters/zfs_arc_max
El L2ARC (caché de lectura en SSD) solo ayuda cuando el conjunto de datos activo supera la RAM y los discos del pool son lentos. Su índice también consume RAM. En un pool todo SSD rara vez aporta; primero agregue RAM.
SLOG y vdevs especiales, bien explicados
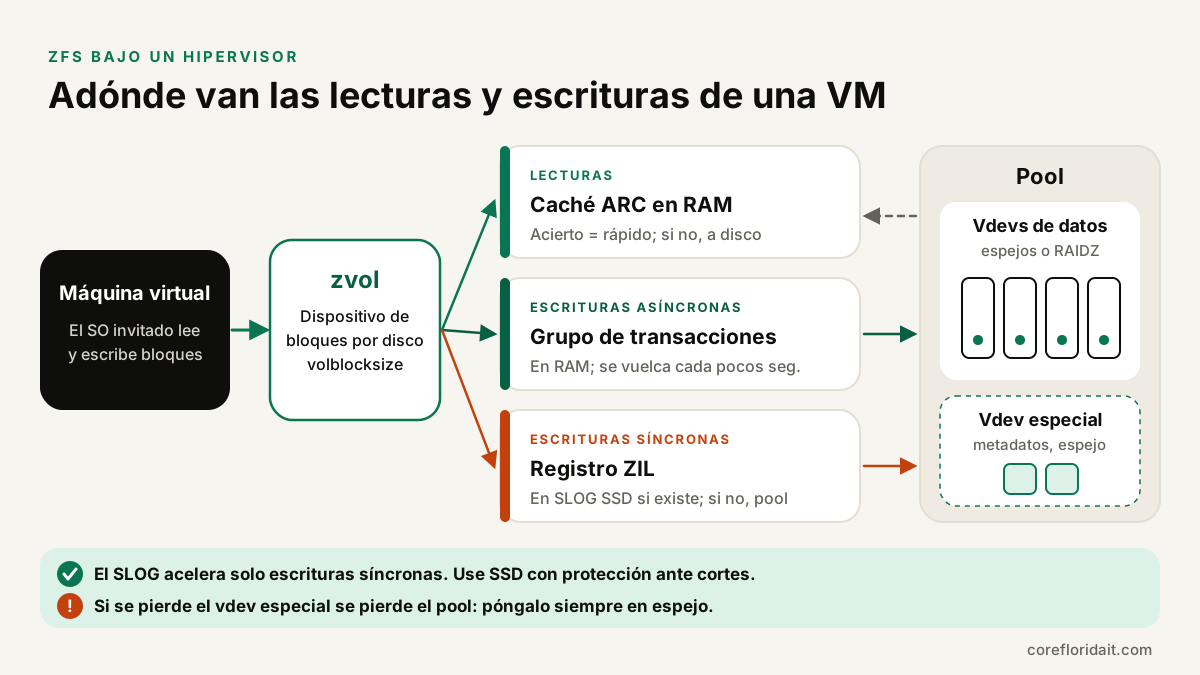
- ZIL y SLOG. Las escrituras asíncronas se juntan en RAM y se graban en disco en grupos de transacciones cada pocos segundos. Las escrituras síncronas (bases de datos, NFS, iSCSI, VMs con
sync=alwayso ciertos modos de caché) deben estar en almacenamiento estable antes de que ZFS las confirme, así que primero van al ZFS Intent Log (ZIL). Por defecto el ZIL vive en los discos del pool. Un SLOG es un dispositivo rápido aparte que aloja el ZIL. Solo acelera escrituras síncronas; con cargas asíncronas no hace nada y no es una caché de escritura general. Un SLOG debe tener protección ante pérdida de energía (PLP) para que lo confirmado como seguro sobreviva a un corte. - Vdev especial. Guarda los metadatos del pool y, opcionalmente, bloques pequeños de archivos (
special_small_blocks) en SSD rápidos, algo útil en pools de discos duros. A diferencia del L2ARC o el SLOG, el vdev especial forma parte del pool: si falla sin redundancia, se pierde el pool. Póngalo siempre en espejo, con el mismo nivel de redundancia que el pool.
## SLOG en espejo (NVMe con PLP) para un pool con muchas escrituras síncronas
zpool add tank log mirror /dev/disk/by-id/nvme-PLP_1 /dev/disk/by-id/nvme-PLP_2

## Vdev especial en espejo para los metadatos de un pool HDD
zpool add tank special mirror /dev/disk/by-id/ssd-S1 /dev/disk/by-id/ssd-S2
Nunca configure sync=disabled en el almacenamiento de VMs "para que vaya más rápido": confirma escrituras que todavía no están seguras y un corte de luz puede corromper sistemas de archivos y bases de datos de los invitados.
Los snapshots no son respaldos
Los snapshots de ZFS son instantáneos y baratos, ideales antes de una actualización o un cambio riesgoso. Pero viven en el mismo pool, así que no protegen ante la pérdida del pool, una falla de controladora, robo, incendio, inundación o un atacante con permisos de administrador que borre datos y snapshots. La protección real exige copias separadas:
- Proxmox Backup Server en hardware aparte, con deduplicación y tareas de verificación;
- una copia fuera de la oficina o en la nube que un administrador del hipervisor comprometido no pueda borrar;
- la regla de respaldo 3-2-1, probada con restauraciones periódicas.
En oficinas del sur de Florida, mantenga al menos una copia fuera del edificio expuesto a huracanes y tenga claro cómo restaurarla de forma remota.
Scrubs y monitoreo SMART
Un scrub lee todos los bloques del pool, verifica los checksums y repara lo dañado a partir de la redundancia. Debian/Proxmox incluye un scrub mensual programado en /etc/cron.d/zfsutils-linux; confirme que existe o agregue el suyo:
## Ver salud, errores y resultado del último scrub
zpool status -v
zpool list -o name,size,alloc,free,cap,health

## Ejemplo de cron (/etc/cron.d/zfs-scrub): scrub cada domingo a las 02:00
0 2 * * 0 root /usr/sbin/zpool scrub vmpool
Combine los scrubs con monitoreo SMART (smartmontools) para reemplazar discos que fallan antes de que falle un segundo, y verifique que el demonio de eventos de ZFS (ZED) y el sistema de notificaciones de Proxmox envíen alertas a un buzón que alguien revise:
smartctl -a /dev/nvme0
## Activar alertas en /etc/zfs/zed.d/zed.rc, por ejemplo ZED_EMAIL_ADDR="[email protected]"
Replicación entre nodos Proxmox
La replicación de almacenamiento de Proxmox (pvesr) usa ZFS send/receive para copiar los discos de las VMs a otro nodo según un calendario (cada 15 minutos por defecto). Si el nodo principal falla, puede arrancar la VM en la réplica perdiendo solo los cambios desde la última sincronización, mucho más rápido que una restauración completa. Requisitos y notas:
- Almacenamiento ZFS con el mismo ID de almacenamiento en ambos nodos, dentro de un clúster Proxmox.
- La replicación es asíncrona: complementa a los respaldos, no los reemplaza.
- Con alta disponibilidad activada, la conmutación reinicia la VM desde el último estado replicado.
- Dimensione el enlace: la primera sincronización copia el disco completo; después, solo los cambios.
## Replicar la VM 101 al nodo pve2 cada 15 minutos
pvesr create-local-job 101-0 pve2 --schedule "*/15"
pvesr status
Errores comunes
- RAID por hardware debajo de ZFS. ZFS necesita acceso directo a cada disco para detectar y reparar errores. Use una HBA en modo IT/pass-through, no un volumen RAID.
- SSD de consumo sin PLP. Pueden perder escrituras ya confirmadas ante un corte y se desgastan rápido con los patrones de escritura de las VMs. Elija SSD empresariales o de centro de datos, sobre todo para SLOG y vdevs especiales.
- Llenar el pool. ZFS es copy-on-write y necesita espacio libre para escribir con eficiencia. Como pauta de planificación, empiece a ampliar mucho antes de que el pool se acerque a estar lleno y configure alertas de capacidad.
- ashift incorrecto. Dejar que un disco reporte sectores de 512 bytes y crear vdevs con
ashift=9. - Usar nombres /dev/sdX. Pueden cambiar al reiniciar; use
/dev/disk/by-id/. - RAIDZ1 con discos duros grandes para VMs importantes.
- Vdev especial sin espejo, o un SLOG agregado creyendo que acelera todas las escrituras.
- Sin scrubs, sin alertas SMART, sin respaldos fuera del host.
Preguntas frecuentes
¿Espejos o RAIDZ para VMs en Proxmox?
Use espejos en franja para discos de VMs y bases de datos, porque el I/O aleatorio escala con la cantidad de vdevs. Use RAIDZ2 para respaldos y datos masivos, donde importa más la capacidad que las IOPS.
¿Necesito un SLOG?
Solo si su carga genera muchas escrituras síncronas (bases de datos, carpetas NFS o iSCSI, VMs con configuraciones de sync exigentes) y los discos del pool son más lentos que el dispositivo SLOG. En la mayoría de los pools todo NVMe, un SLOG aporta poco.
¿Cuánta RAM necesita ZFS?
ZFS funciona con RAM moderada; más RAM simplemente significa una caché de lectura mayor. En un hipervisor, limite el ARC para que las VMs tengan lo que necesitan y luego ajuste según las tasas de acierto de arc_summary.
¿La replicación de ZFS alcanza para proteger mis datos?
No. La replicación protege ante la falla de un nodo con una pequeña ventana de pérdida, pero también copia borrados, corrupción dentro del invitado y el cifrado de un ransomware. Mantenga respaldos versionados en sistemas separados.
Diseñe bien su almacenamiento
Core Florida IT diseña y da soporte a clústeres Proxmox con ZFS para empresas de Miami, Broward y todo el sur de Florida, y administra servidores de forma remota en todo el país: selección de hardware, diseño del pool, replicación, monitoreo y instalación y reparación de servidores. ¿Está saliendo de VMware? Vea nuestra guía de migración de VMware a Proxmox. Solicite una evaluación de TI gratuita y Max y el equipo revisarán su almacenamiento actual antes de que compre nada.