Clúster de alta disponibilidad con Proxmox para pequeñas empresas: quórum, almacenamiento y conmutación
Cómo construir un clúster HA de Proxmox VE confiable para una pequeña empresa: quórum y QDevice, elegir Ceph, replicación ZFS o NAS, redes Corosync separadas, fencing por watchdog y pruebas reales.
Un clúster de alta disponibilidad con Proxmox permite que una pequeña empresa mantenga sus máquinas virtuales funcionando cuando falla un servidor: los nodos restantes detectan la falla, aíslan (fencing) el nodo caído y reinician sus cargas de trabajo de forma automática. Para hacerlo con seguridad necesita tres votos de quórum (tres nodos, o dos nodos más un QDevice), almacenamiento compartido o replicado, una red dedicada para Corosync y un fencing que funcione. La alta disponibilidad reduce el tiempo caído; nunca reemplaza los respaldos.
Puntos clave
- Planifique tres nodos. Dos nodos solo funcionan con un QDevice externo que desempate.
- Elija el almacenamiento con criterio: Ceph para almacenamiento compartido sin pérdida de datos al conmutar, replicación ZFS para discos locales rápidos y sencillos con un pequeño margen de replicación, o un NAS/SAN externo por NFS o iSCSI.
- Dele a Corosync su propia red (idealmente dos enlaces). Mezclarla con el tráfico de almacenamiento es una causa clásica de fencing inesperado.
- Pruebe la conmutación cortando la energía, no solo con un apagado ordenado, y mantenga respaldos en Proxmox Backup Server.
¿Cuándo necesita una pequeña empresa alta disponibilidad en Proxmox?
No todas las empresas necesitan un clúster. Si unas horas sin servicio mientras restaura un respaldo son aceptables, un solo servidor bien construido con buenos respaldos puede ser la respuesta correcta. La alta disponibilidad se justifica cuando el tiempo caído sale caro: una empresa de logística en Doral cuyo sistema de despacho funciona las 24 horas, un consultorio médico con la pasarela de su expediente clínico y los teléfonos en servidores locales, o una firma contable en Fort Lauderdale en plena temporada de impuestos.
Si viene de VMware, lea primero nuestra comparación entre Proxmox y VMware y la guía de migración de VMware a Proxmox. Los conceptos de alta disponibilidad son parecidos, pero en Proxmox VE las decisiones de almacenamiento y red son más explícitas.
Arquitectura: cómo se ve un clúster HA pequeño de Proxmox
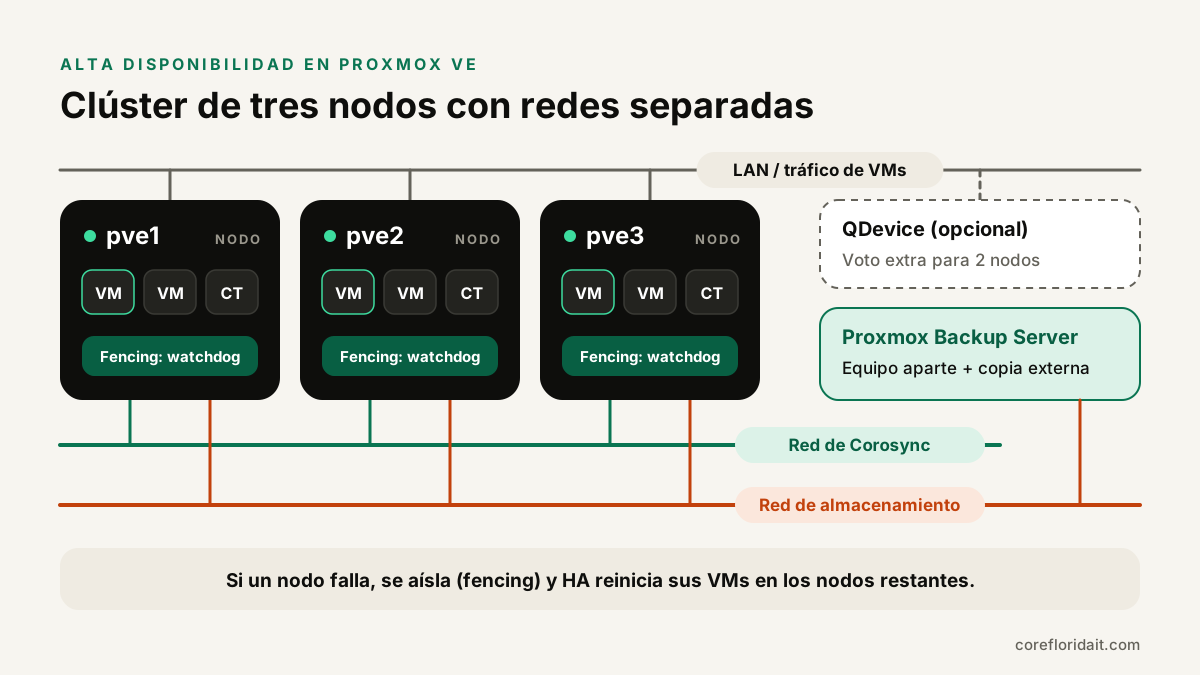
Un diseño típico para una pequeña empresa incluye:
- Tres nodos similares con la misma generación de CPU (o un tipo de CPU virtual común) para que la migración en vivo funcione entre ellos.
- Tres redes: la LAN de clientes para el tráfico de las VMs, una red dedicada de Corosync para la comunicación del clúster y una red de almacenamiento para el tráfico de Ceph o de replicación.
- Almacenamiento compartido o replicado, para que el disco de cada VM esté disponible en el nodo que la recibe.
- Un watchdog en cada nodo para el fencing.
- Proxmox Backup Server en hardware aparte, con una copia fuera de la oficina.
Quórum y Corosync: por qué importan tres votos
Proxmox VE usa Corosync para mantener la membresía y la configuración del clúster en orden. El clúster solo hace cambios, y la alta disponibilidad solo recupera cargas, cuando hay mayoría de votos (quórum). Con tres nodos, dos cualesquiera siguen funcionando si uno falla. Con dos nodos, perder uno deja un solo voto, que no es mayoría, y nada se recupera.
Crear un clúster con dos enlaces redundantes de Corosync se ve así:
pvecm create corecluster --link0 10.10.10.11 --link1 10.20.20.11   # en pve1

pvecm add 10.10.10.11 --link0 10.10.10.12 --link1 10.20.20.12   # en pve2 y pve3 (se unen a través de pve1)
pvecm add 10.10.10.11 --link0 10.10.10.13 --link1 10.20.20.13

pvecm status
¿Solo dos nodos? Agregue un QDevice
Si solo tiene dos servidores, agregue un QDevice externo: un pequeño equipo Linux o una VM fuera del clúster que ejecuta corosync-qnetd y aporta el voto de desempate.
apt install corosync-qnetd   # en el equipo externo del QDevice

apt install corosync-qdevice   # en cada nodo del clúster

pvecm qdevice setup 10.10.10.50   # en un nodo del clúster
Proxmox recomienda el QDevice para clústeres con un número par de nodos, no impar. Nunca aloje el QDevice como VM dentro del mismo clúster que debe arbitrar.
Reglas de red para Corosync
Corosync necesita latencia baja y estable más que ancho de banda. Ponga link0 en una tarjeta y un switch dedicados (o una VLAN en puertos dedicados) y link1 por otro camino físico. Si el tráfico de respaldos, Ceph o migraciones satura el enlace de Corosync, los nodos pueden perder contacto, perder el quórum y aislarse a sí mismos aunque nada esté realmente dañado.
Opciones de almacenamiento: Ceph, replicación ZFS o NAS/iSCSI
Para que la alta disponibilidad reinicie una VM en otro nodo, ese nodo debe poder llegar al disco de la VM. Hay tres opciones prácticas.
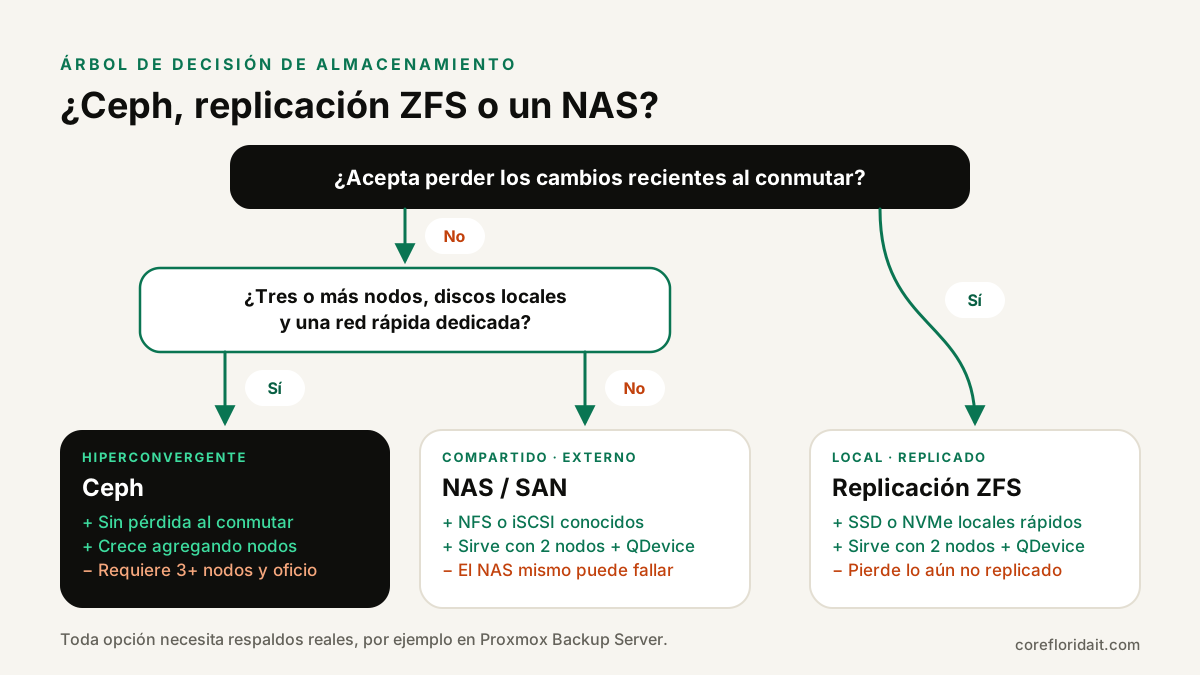
| Ceph (hiperconvergente) | Replicación ZFS | NAS/SAN (NFS o iSCSI) | |
|---|---|---|---|
| Datos al conmutar | Compartidos, sin pérdida de escrituras confirmadas | Se pierden los cambios desde la última replicación | Compartidos, sin pérdida |
| Nodos mínimos | Tres (más es mejor) | Dos más QDevice | Dos más QDevice |
| Red | Red de almacenamiento rápida y dedicada (se recomienda 10 GbE o más) | Tráfico de replicación, exigencia moderada | Red de almacenamiento dedicada |
| Punto único de falla | Ninguno si está bien dimensionado | Ninguno | El propio equipo de almacenamiento, salvo que sea redundante |
| Conocimientos necesarios | Los más altos: vigilar OSDs, grupos de ubicación y recuperación | Moderados | Moderados, según el fabricante |
| Ideal para | Clústeres en crecimiento que necesitan almacenamiento compartido real | Clústeres pequeños donde se acepta un margen corto de datos | Firmas que ya tienen un arreglo de almacenamiento confiable |
Ceph
Proxmox VE integra la administración de Ceph. Una instalación básica:
pveceph install
pveceph init --network 10.30.30.0/24
pveceph mon create          # en cada uno de los tres nodos
pveceph osd create /dev/nvme0n1   # por disco de datos, en cada nodo
pveceph pool create vmpool --add_storages
Use SSD o NVMe empresariales con protección ante cortes de energía, mantenga las tres réplicas predeterminadas para los pools de VMs y deje capacidad libre suficiente para que Ceph vuelva a replicar los datos después de la falla de un disco o un nodo.
Replicación ZFS
Cada nodo guarda las VMs en ZFS local y Proxmox replica instantáneas a otro nodo según un calendario. Si un nodo falla, la alta disponibilidad arranca la VM desde la última réplica, así que solo se pierde lo que cambió desde la última ejecución. El almacenamiento debe tener el mismo nombre en todos los nodos.
pvesr create-local-job 100-0 pve2 --schedule "*/15"   # replicar la VM 100 a pve2 cada 15 minutos
pvesr status
NAS o SAN
Un arreglo externo por NFS o iSCSI es conocido y fácil de entender, pero asegúrese de que el propio equipo sea redundante (controladoras dobles, fuentes y red redundantes); de lo contrario se convierte en la única falla capaz de tumbarlo todo.
Fencing y el watchdog
El fencing garantiza que un nodo con falla o aislado se detuvo de verdad antes de que sus VMs arranquen en otro lado; si no, dos copias de la misma VM podrían escribir sobre el mismo disco y corromperlo. Proxmox VE usa autofencing con watchdog: el nodo que pierde el quórum deja de renovar su watchdog y se reinicia, y los demás nodos esperan lo suficiente para estar seguros antes de recuperar sus servicios.
Por defecto Proxmox usa el watchdog por software de Linux (softdog). Si sus servidores tienen un watchdog de hardware compatible, como IPMI, puede activarlo:
WATCHDOG_MODULE=ipmi_watchdog # /etc/default/pve-ha-manager
Reinicie después del cambio y confirme que el módulo cargó.
Recursos HA, grupos y migración en vivo
Agregue a la alta disponibilidad las VMs que importan. No todas lo necesitan; los sistemas de prueba y las herramientas no críticas pueden quedar en manual.
ha-manager add vm:100 --state started --max_restart 1 --max_relocate 1
ha-manager status
Use grupos HA (en Proxmox VE 8) o reglas HA (en Proxmox VE 9, que reemplaza los grupos por reglas de afinidad de nodos y de recursos) para controlar dónde prefiere ejecutarse cada servicio, por ejemplo para mantener dos controladores de dominio en nodos distintos. Configure también la política de apagado del datacenter (por ejemplo migrate) para que el mantenimiento planificado mueva las VMs en lugar de detenerlas.
Para mantenimiento, la migración en vivo mueve una VM encendida entre nodos sin tiempo caído:
qm migrate 100 pve2 --online
qm migrate 100 pve2 --online --with-local-disks   # con discos ZFS locales y replicación
Pruebe la conmutación antes de confiar en ella
Un clúster que nunca conmutó en una prueba lo sorprenderá en producción. Programe una ventana de mantenimiento y:
- Migre en vivo cada VM con HA a todos los nodos y de regreso.
- Corte la energía de un nodo (no un apagado ordenado) y observe cómo HA lo aísla y reinicia sus VMs en otro nodo.
- Desconecte un enlace de Corosync y confirme que el clúster mantiene el quórum por el segundo enlace.
- Simule la falla de un disco (o marque un OSD de Ceph como fuera) y confirme que el almacenamiento se recupera.
- Restaure una VM desde el respaldo para comprobar que la última línea de defensa funciona.
Anote cuánto tardó cada paso y qué notaron los usuarios. Eso se convierte en su manual de procedimientos.
La alta disponibilidad no es un respaldo
La alta disponibilidad lo protege de fallas de hardware. No lo protege del ransomware, de una carpeta borrada, de una actualización defectuosa ni de un cuarto de servidores inundado: todo eso se replica o se comparte junto con sus datos buenos. Mantenga respaldos programados en Proxmox Backup Server sobre hardware aparte, sincronice una copia fuera de la oficina y pruebe las restauraciones. En el sur de Florida, piense también en la temporada de huracanes: un clúster HA dentro de un solo cuarto en planta baja sigue siendo un solo sitio.
Errores comunes
- Dos nodos sin QDevice, que no pueden recuperar nada cuando uno falla.
- Corosync en el mismo enlace congestionado que el almacenamiento y los respaldos.
- SSD de consumo en Ceph, que pueden ser lentos y desgastarse rápido con las escrituras de replicación.
- Generaciones de CPU mezcladas con el tipo de CPU "host", lo que impide la migración en vivo.
- Alta disponibilidad en todo, incluso en VMs que nunca deberían arrancar solas en otro nodo.
- Sin respaldos "porque tenemos HA".
Preguntas frecuentes
¿Cuántos nodos necesito para alta disponibilidad en Proxmox?
Tres es el mínimo recomendado. Dos nodos pueden funcionar con un QDevice externo que aporte el tercer voto, pero en ambos casos necesita almacenamiento compartido o replicado.
¿Ceph es demasiado para una pequeña empresa?
No siempre, pero requiere tres o más nodos, discos adecuados, una red rápida dedicada y alguien que lo supervise. Para muchos clústeres pequeños, la replicación ZFS o un NAS confiable son más sencillos y suficientes.
¿Los usuarios notarán cuando falle un nodo?
Con alta disponibilidad, las VMs del nodo caído se reinician en otro nodo después del fencing, así que los usuarios ven una interrupción breve, parecida a un reinicio, no un traspaso invisible. La migración en vivo para mantenimiento planificado es el caso sin tiempo caído visible.
¿Necesito una suscripción de Proxmox para usar HA?
La alta disponibilidad viene incluida en Proxmox VE sin suscripción. La suscripción da acceso al repositorio empresarial y al soporte del fabricante, algo que muchas empresas eligen para producción.
¿Planea un clúster Proxmox o salir de VMware? Nuestros equipos de virtualización con Proxmox y de instalación y reparación de servidores diseñan, construyen y prueban clústeres de alta disponibilidad para empresas en Miami-Dade, Broward y todo el país. Solicite una evaluación de TI gratuita y revisaremos sus cargas de trabajo para recomendarle el diseño de clúster y almacenamiento adecuado.