IA privada en sus instalaciones: cómo usar un LLM local en su empresa
Mantenga consultas y documentos confidenciales en hardware que usted controla. Guía práctica de LLM locales: servidores de modelos, memoria de GPU y cuantización, seguridad, passthrough en Proxmox y la decisión nube vs local.
Tener IA privada en sus instalaciones significa ejecutar un modelo de lenguaje de pesos abiertos en un servidor que usted controla, de modo que las consultas, los documentos y las respuestas nunca salen de su red. Para una pequeña empresa tiene sentido cuando los datos son confidenciales, las tareas están bien definidas y alguien puede mantener el sistema actualizado; para redacción abierta y razonamiento complejo, una API de IA en la nube con contrato empresarial suele seguir siendo la mejor herramienta. En esta guía explicamos cómo funciona un LLM local, cómo dimensionar el hardware sin adivinar y cómo protegerlo.
Puntos clave
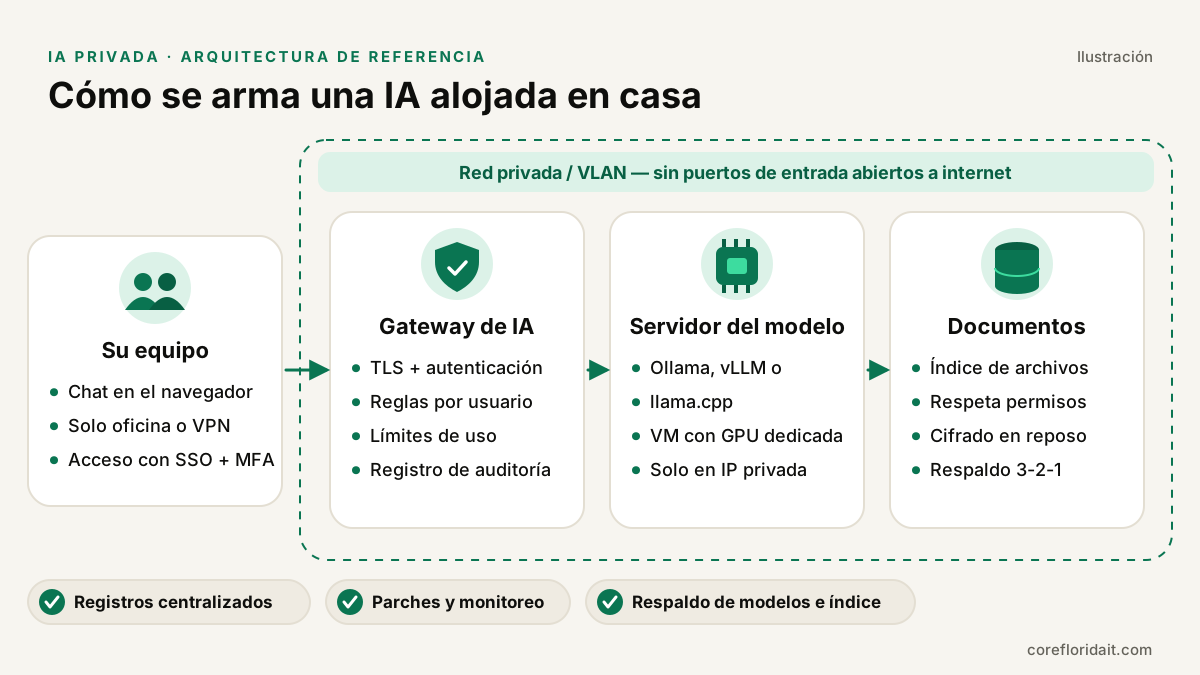
- Una IA local tiene cuatro piezas: un gateway con autenticación, un servidor de modelos (Ollama, vLLM o llama.cpp), una GPU con memoria suficiente y un repositorio de documentos que respete permisos.
- La memoria de la GPU (VRAM) es la principal limitación. El tamaño del modelo, el nivel de cuantización y el largo del contexto determinan qué cabe.
- "Local" no significa "seguro": las APIs de los servidores de modelos traen poca o ninguna autenticación y nunca deben quedar expuestas a internet.
- Muchas firmas terminan con un esquema híbrido: modelos privados para documentos confidenciales y un servicio en la nube evaluado para todo lo demás.
- En Proxmox, el passthrough de GPU permite correr el servidor de IA como una VM más, con snapshots, respaldos y aislamiento.
Qué significa realmente "IA privada"
Cuando alguien del equipo pega un contrato en un chatbot público, ese texto viaja a un tercero y se maneja según las condiciones del proveedor. Los planes empresariales de los grandes proveedores de IA ofrecen protecciones reales (no entrenar con sus datos, controles de retención) y para muchas tareas eso alcanza. La IA privada va un paso más allá: los pesos del modelo se descargan una vez y se ejecutan en su propio hardware, en el rack de la oficina o en un servidor dedicado bajo su control. La consulta, los documentos recuperados y la respuesta se quedan dentro de su red.
Esto es posible gracias a los modelos de pesos abiertos: modelos cuyos parámetros entrenados se publican para descarga bajo una licencia (familias como Llama, Mistral, Qwen y Gemma son ejemplos conocidos). Cada licencia tiene sus propias condiciones de uso comercial, así que conviene leerla antes de implementar.
Las piezas de un LLM local
Servidores de modelos: Ollama, vLLM y llama.cpp
| Herramienta | En qué se destaca | Uso típico |
|---|---|---|
| llama.cpp | Motor de inferencia eficiente en C/C++; ejecuta modelos GGUF cuantizados en GPU, CPU o ambos | Servidores chicos, hardware mixto, máximo control |
| Ollama | Herramienta sencilla (construida originalmente sobre llama.cpp) que descarga y sirve modelos con un comando y una API HTTP | Pilotos, un solo equipo, evaluaciones rápidas |
| vLLM | Servidor de alto rendimiento con API compatible con OpenAI, gestión eficiente de memoria y procesamiento por lotes | Muchos usuarios simultáneos, APIs en producción con GPUs dedicadas |
Las tres exponen una API HTTP que puede usar una interfaz de chat, un asistente de documentos o sus propias aplicaciones de negocio con IA.
El gateway
Coloque un gateway delante del servidor de modelos: un proxy inverso o gateway de IA que termine TLS, exija inicio de sesión único (SSO) con MFA, aplique permisos por usuario o grupo, limite el volumen de solicitudes y registre un log de auditoría. Las laptops nunca deben hablar directamente con el puerto del modelo.
El repositorio de documentos (recuperación)
Buena parte del valor viene de la generación aumentada por recuperación (RAG): el sistema busca en sus documentos aprobados, le pasa los fragmentos relevantes al modelo y le pide que responda a partir de ellos. La regla de diseño clave es que la búsqueda respete los permisos existentes. Si un asociado no puede abrir una carpeta reservada a los socios en el servidor de archivos, la IA tampoco debe poder citarla.
Cómo dimensionar el hardware: VRAM, cuantización y contexto
No necesita un centro de datos, pero sí entender una restricción: el modelo tiene que caber en la memoria de la GPU para responder a una velocidad útil.
- Parámetros. El tamaño de un modelo se expresa en miles de millones de parámetros. Más parámetros suele significar mejores respuestas y más memoria.
- Cuantización. Normalmente cada peso ocupa 16 bits. La cuantización los guarda con menos bits (8, 5 o 4), reduciendo la memoria casi en la misma proporción, con una pérdida de calidad moderada que aumenta a medida que se baja. Es como una foto comprimida de buena calidad: en 8 o 5 bits la diferencia casi no se nota en tareas de negocio; en niveles agresivos, sí.
- Regla práctica aproximada. La memoria para los pesos es más o menos parámetros × bytes por parámetro: en 16 bits, dos bytes por parámetro; en 8 bits, cerca de uno; en 4 bits, cerca de medio byte. Luego hay que sumar margen.
- Contexto y concurrencia. Cada conversación activa necesita una caché KV que crece con el largo del contexto (cuánto texto lee el modelo de una vez) y con la cantidad de usuarios simultáneos. Contratos largos y muchos usuarios exigen VRAM adicional.
Un enfoque práctico:
- Elija dos o tres modelos candidatos para sus tareas reales (resumir cartas de compromiso, redactar primeras respuestas, extraer datos de facturas).
- Pruébelos en una estación de trabajo o en una instancia con GPU por poco tiempo, con sus documentos y no con benchmarks de marketing.
- Quédese con el modelo más chico y la cuantización más suave que cumplan el nivel de calidad, y dimensione la VRAM para ese modelo más el contexto de los usuarios simultáneos esperados.
- Deje margen para crecer: los modelos mejoran rápido y querrá cambiarlos.
La inferencia solo con CPU sirve para pruebas y tareas por lotes de bajo volumen, pero el uso interactivo de un equipo requiere GPU. Planifique también energía y enfriamiento: un servidor con GPU en un clóset pequeño de una oficina en Brickell o Doral puede recalentarlo, y en temporada de huracanes un UPS dimensionado para la carga es obligatorio.
¿API en la nube o modelo local? Matriz de decisión
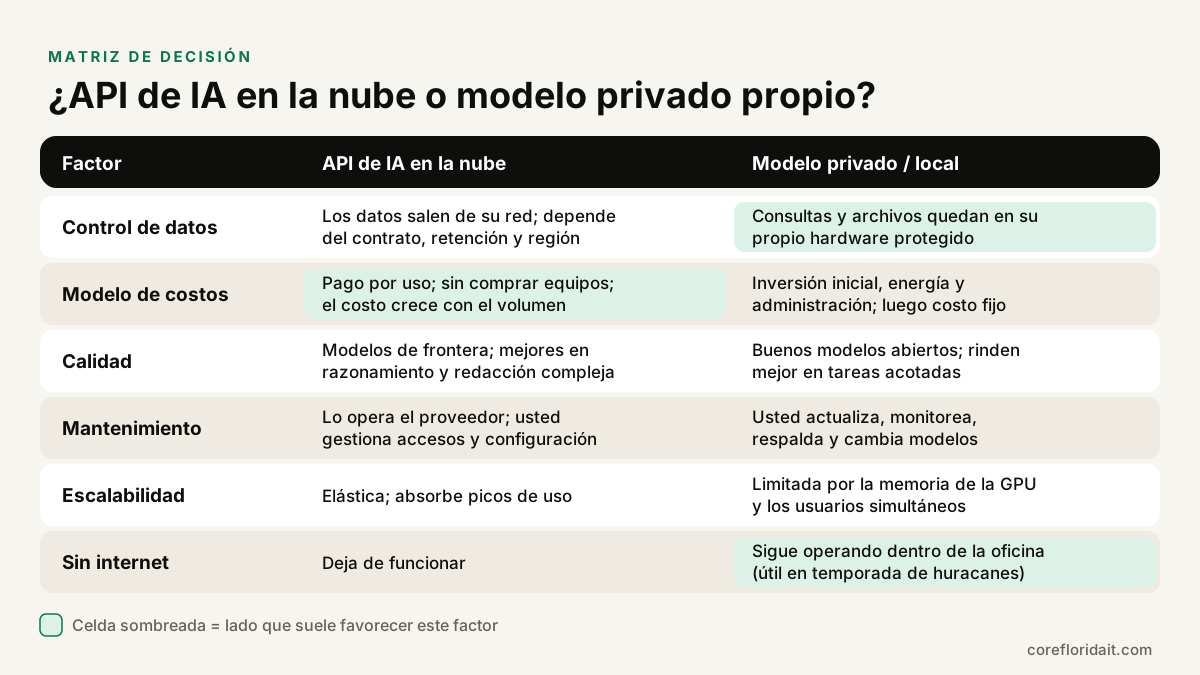
| Factor | API de IA en la nube (plan empresarial) | Modelo privado en su hardware |
|---|---|---|
| Control de datos | Sale de su red; depende del contrato, la retención y la región | Queda en hardware que usted posee y protege |
| Modelo de costos | Pago por uso, sin hardware; crece con el volumen | Inversión inicial, energía y administración; luego previsible |
| Calidad | Modelos de frontera, mejores en razonamiento y redacción compleja | Buenos modelos abiertos, mejores en tareas acotadas |
| Mantenimiento | Lo opera el proveedor; usted gestiona accesos | Usted actualiza, monitorea, respalda y cambia modelos |
| Escalabilidad | Elástica | Limitada por la memoria de la GPU y la concurrencia |
| Corte de internet | Deja de funcionar | Sigue operando dentro de la oficina |
Lo local suele convenir cuando los documentos son muy confidenciales, la carga de trabajo es constante y repetitiva o necesita seguir trabajando sin conexión. La nube suele convenir cuando lo más importante es la calidad en problemas difíciles, el uso es ocasional o nadie puede hacerse cargo del mantenimiento. Un diseño híbrido, que envíe los asuntos confidenciales al modelo local y las tareas generales a un servicio en la nube, suele ser la respuesta más práctica.
Casos de uso para bufetes, firmas contables y consultorios en Miami
- Bufetes de abogados. Resumir transcripciones de declaraciones, armar cronologías preliminares, buscar en trabajos anteriores. La guía ética de The Florida Bar sobre IA generativa (Opinión 24-1) pone el foco en la confidencialidad, la competencia y la supervisión; una implementación privada ayuda con lo primero, pero los abogados siguen revisando cada resultado. Vea soporte de TI para bufetes.
- Firmas de contadores (CPA). Extraer datos de documentos fuente, redactar emails a clientes a partir de notas, responder preguntas del personal sobre el manual de procedimientos de la firma. La información tributaria es justamente la que conviene mantener en casa; vea soporte de TI para firmas CPA.
- Consultorios y prácticas de salud. Redactar plantillas de cartas a pacientes o resumir políticas internas. Correr el modelo localmente no convierte al sistema en compatible con HIPAA por sí solo: sigue necesitando análisis de riesgos, controles de acceso, registros de auditoría y las salvaguardas de la Security Rule. Nuestro equipo de TI para salud diseña esos controles.
- Equipos bilingües. Muchos modelos abiertos manejan bien inglés y español, algo útil para empresas de Doral, Hialeah o Kendall que atienden clientes en ambos idiomas. Haga revisar el español por hablantes nativos antes de implementarlo.
Cómo proteger un LLM local
Alojar el modelo traslada la responsabilidad de seguridad a usted. Trate al servidor de IA como cualquier otro servidor con archivos de clientes.
- Ningún endpoint expuesto. Haga que los servidores de modelos escuchen solo en localhost o en una IP de una VLAN privada. Ollama escucha en 127.0.0.1 por defecto; cambiar
OLLAMA_HOSTa0.0.0.0sin firewall expone una API sin autenticación. Escanee sus IPs públicas para confirmar que nada responde. - Autenticación en todo. Los usuarios entran con SSO y MFA (las passkeys son ideales; vea passkeys para empresas). Las llamadas entre servicios usan claves de API o mTLS; vLLM admite una clave de API, pero no reemplaza al gateway.
- Mínimo privilegio en la búsqueda. Indexe solo fuentes aprobadas y aplique los permisos de cada documento al momento de la consulta.
- Registros con criterio. Registre quién preguntó, cuándo y qué documentos se recuperaron. Decida conscientemente si guarda las consultas completas: un log con consultas confidenciales también es información confidencial, con sus propias reglas de retención.
- Inyección de instrucciones. Un documento malicioso puede contener órdenes dirigidas al modelo. No le dé herramientas para enviar emails, borrar archivos o mover dinero sin aprobación humana. El OWASP Top 10 para aplicaciones con LLM es una buena lista de control.
- Cadena de suministro. Descargue modelos y contenedores de fuentes oficiales, verifique checksums, fije versiones y revise licencias.
- Parches y respaldos. Mantenga actualizados drivers, servidor de modelos y sistema operativo; respalde la configuración, el índice vectorial y los modelos elegidos con la regla 3-2-1.
Una configuración inicial segura para Ollama en una red privada se ve así:
## /etc/systemd/system/ollama.service.d/override.conf
[Service]
## Escuchar solo en la IP privada de la VLAN, nunca en 0.0.0.0
Environment="OLLAMA_HOST=10.20.30.15:11434"

## Firewall: solo el gateway puede llegar al puerto del modelo
ufw default deny incoming
ufw allow from 10.20.30.10 to any port 11434 proto tcp
ufw enable
Compleméntela con una política de uso de IA para que el personal sepa qué herramienta usar con cada tipo de dato.
Correrlo como VM: passthrough de GPU en Proxmox
Si ya usa virtualización con Proxmox, el servidor de IA puede ser una VM más. Con PCI passthrough, Proxmox entrega una GPU física directamente a una VM: el driver del invitado controla la tarjeta con rendimiento casi nativo y usted conserva snapshots, respaldos y aislamiento a nivel de VM.
Pasos generales (el wiki de Proxmox tiene el detalle):
- Active IOMMU en el BIOS/UEFI (Intel VT-d o AMD-Vi) y en la línea de comandos del kernel.
- Cargue los módulos VFIO y confirme que la GPU está en su propio grupo IOMMU.
- Ponga en lista negra el driver de la GPU en el host o asocie la tarjeta a
vfio-pcipara que el host no la tome. - Cree la VM con tipo de máquina q35 y OVMF (UEFI) y agregue la GPU como dispositivo PCI.
- Instale el driver del fabricante dentro del invitado y verifique que la tarjeta aparece antes de instalar el servidor de modelos.
## Host Proxmox: confirmar IOMMU y ubicar el grupo de la GPU
dmesg | grep -e DMAR -e IOMMU
for d in /sys/kernel/iommu_groups/*/devices/*; do
  echo "grupo $(basename $(dirname $(dirname $d))): $(lspci -nns ${d##*/})"
done
Una GPU en passthrough pertenece a una sola VM a la vez, y una VM con un dispositivo físico asignado no puede migrarse en vivo. Planifique ventanas de mantenimiento y documente cómo reconstruirla; nuestra guía de Proxmox Backup Server cubre la parte de respaldos.
Errores comunes
- Abrir el puerto del modelo a internet "solo para probar".
- Elegir el modelo más grande que se pueda descargar en vez del más chico que resuelve la tarea.
- Indexar todo el servidor de archivos, incluidas carpetas de RR. HH. o de socios.
- Suponer que local equivale a cumplimiento normativo, sin análisis de riesgos ni auditoría.
- Darle al modelo acciones de escritura (emails, borrado de archivos) sin aprobación humana.
- No tener UPS, plan de enfriamiento ni respaldo del índice y la configuración.
Preguntas frecuentes
¿Un LLM local es tan bueno como los grandes modelos en la nube?
Por lo general no en razonamiento abierto y redacción extensa, donde lideran los modelos de frontera. En tareas acotadas como resumir, extraer datos y responder a partir de sus propios documentos, un modelo abierto bien elegido suele ser suficiente. Pruebe con sus datos reales antes de decidir.
¿Necesitamos un servidor con GPU dedicado?
Para un piloto puede alcanzar una GPU de estación de trabajo. Para un equipo que lo use a diario, planifique un servidor con GPU profesional, buen enfriamiento y UPS, o una VM con GPU en un host Proxmox existente.
¿La IA privada nos hace cumplir con HIPAA o con las reglas del Bar?
Ninguna herramienta lo logra sola. Elimina un riesgo (enviar datos a un tercero), pero siguen haciendo falta controles de acceso, auditoría, políticas, capacitación y revisión profesional de los resultados.
¿Podemos empezar en la nube y pasar a local después?
Sí. Si sus aplicaciones llaman a una API compatible con OpenAI, cambiar el backend de un servicio en la nube a vLLM u Ollama es sobre todo configuración, lo que mantiene abiertas sus opciones.
Planifique su IA privada con Core Florida IT
Core Florida IT diseña IA privada e híbrida para firmas profesionales en Miami, Broward y todo el sur de Florida, y da soporte remoto a equipos en todo el país: dimensionamiento de hardware, passthrough de GPU en Proxmox, gateways seguros, búsqueda con permisos y capacitación del personal. Max y el equipo revisarán con usted sus casos de uso y sus datos antes de recomendar cualquier equipo. Solicite una evaluación de TI gratuita o agende una llamada por Zoom.